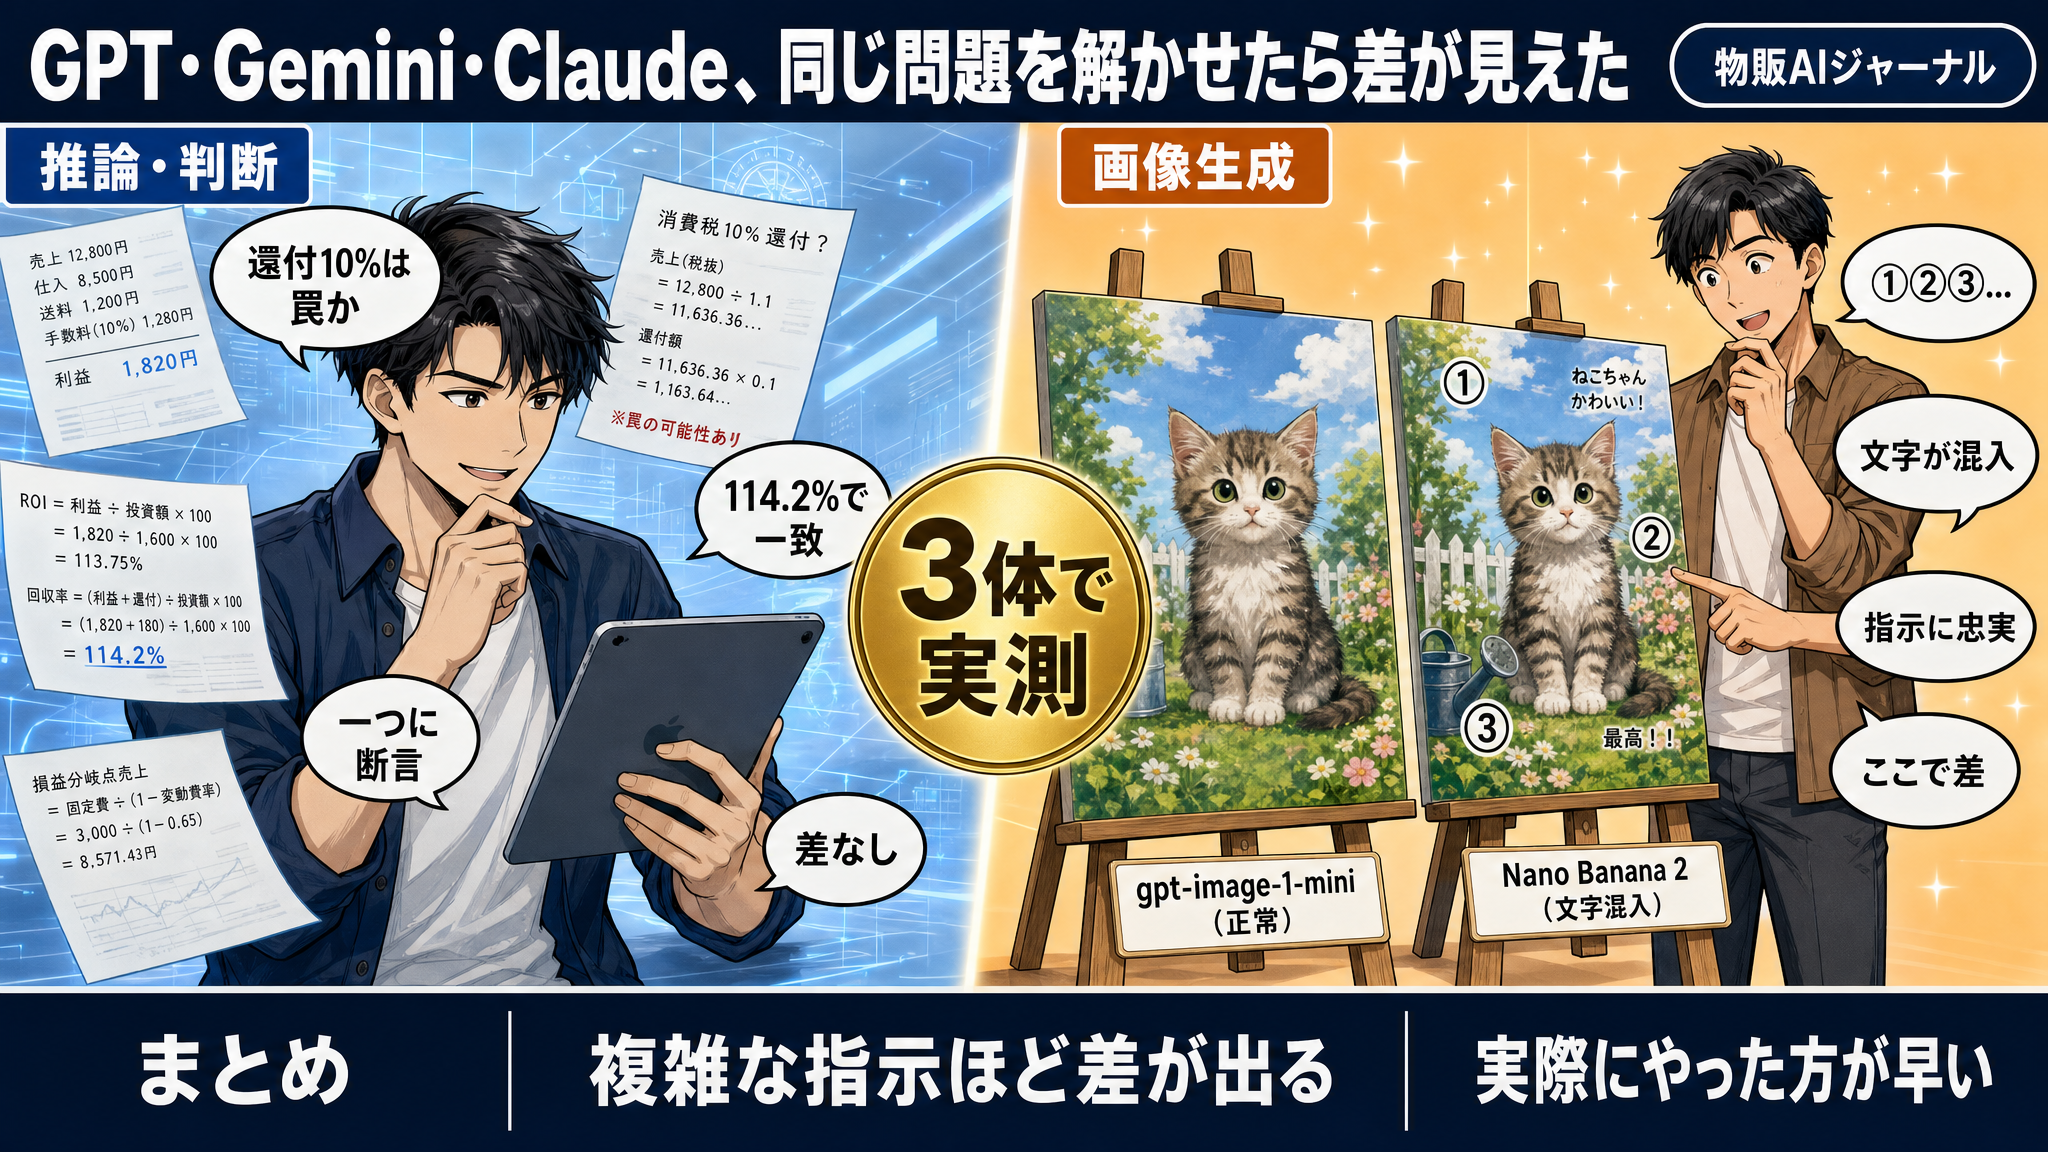
「AIはどれも同じ」で止まっている人、多い。
だったら確かめればいい。うちは今日、GPT-5.5・Gemini Pro・Claudeの3体に、
まったく同じ問題を投げてみた。推論の罠、断言できるかどうか、複雑な画像プロンプト
結果だけ先に言うと、差が出た場所と出なかった場所が、はっきり分かれました
理論の話はしない。実際にやった結果だけを書きます
テスト①:推論の罠。3体とも、罠には気づいた
まず用意したのは、EC実務のちょっとした落とし穴問題で
$40で仕入れた商品を$120で売った。eBay手数料13.6%、送料実費$18はセラー負担。仕入れ額の10%が消費税還付として後日別途戻ってくる(ただしこの還付は損益計算に含めない)。仕入れ値に対する利益率は何%か。
還付の10%を、うっかり利益に足してしまうと答えが狂う。典型的な「もっともらしい罠」。
結果、GPT-5.5もGemini Proも、正解の114.2%を一発で出した。
計算過程もほぼ同じで、還付を正しく除外していた。差はゼロ。
正直、拍子抜けした。でもこれは悪い結果じゃない。今の主要モデルは、この手の罠にはもう強い。
「AIは計算を間違える」という前提で仕事を任せているなら、
その前提自体を疑った方がいい場面もある、ということだ。
テスト②:断言できるか。3体とも逃げなかった。でも理由の質が違った
次は、事実問題じゃなく判断が要る質問にした。
eBay仕入れで、利益率は高いが回転が遅い商品Aと、利益率は低いが回転が速い商品B。初心者はどちらを優先すべきか。「場合による」ではなく一つに断言して。
GPT-5.5、Gemini Pro、Claude、3体とも商品B(回転優先)で一致。
両論併記に逃げるモデルはゼロだった。
ただし理由の中身に差があった。
GPT-5.5は「資金回収が早く、経験を回せる」という一般的なビジネス理屈
Gemini Proは「販売実績が貯まると、eBayの出品リミットの拡大(リミットアップ)が早く進む」という、eBay特有の実務知識を根拠に入れてきた。
判断そのものは同じでも、その判断を支える知識の解像度が違う。
うちの場合、EC実務の細部で聞くならGeminiの方が「現場を知っている答え」に寄る、
という手応えだった。
同じ形式で、もっと価値観が割れる質問(具体的な中身はここでは伏せる)も試した。
結果は同じで、3体とも両論併記には逃げず、一つに断言してきた。
逃げるかどうかはモデルの個性というより、「断言してください」という指示に
どこまで従えるかの素直さで決まるようだ。
テスト③:複雑な画像プロンプト。ここで初めて、はっきり差が出た
最後は画像生成。猫3匹を並べて、帽子の色・視線の向き・本を読んでいるかどうかを
個別に指定する複雑なプロンプトを、gpt-image-1-miniとNano Banana 2(Gemini)の両方に投げた。
帽子の色、位置、視線、読書の有無。この4条件は両方とも完璧に守った。ここは差がつかなかった。
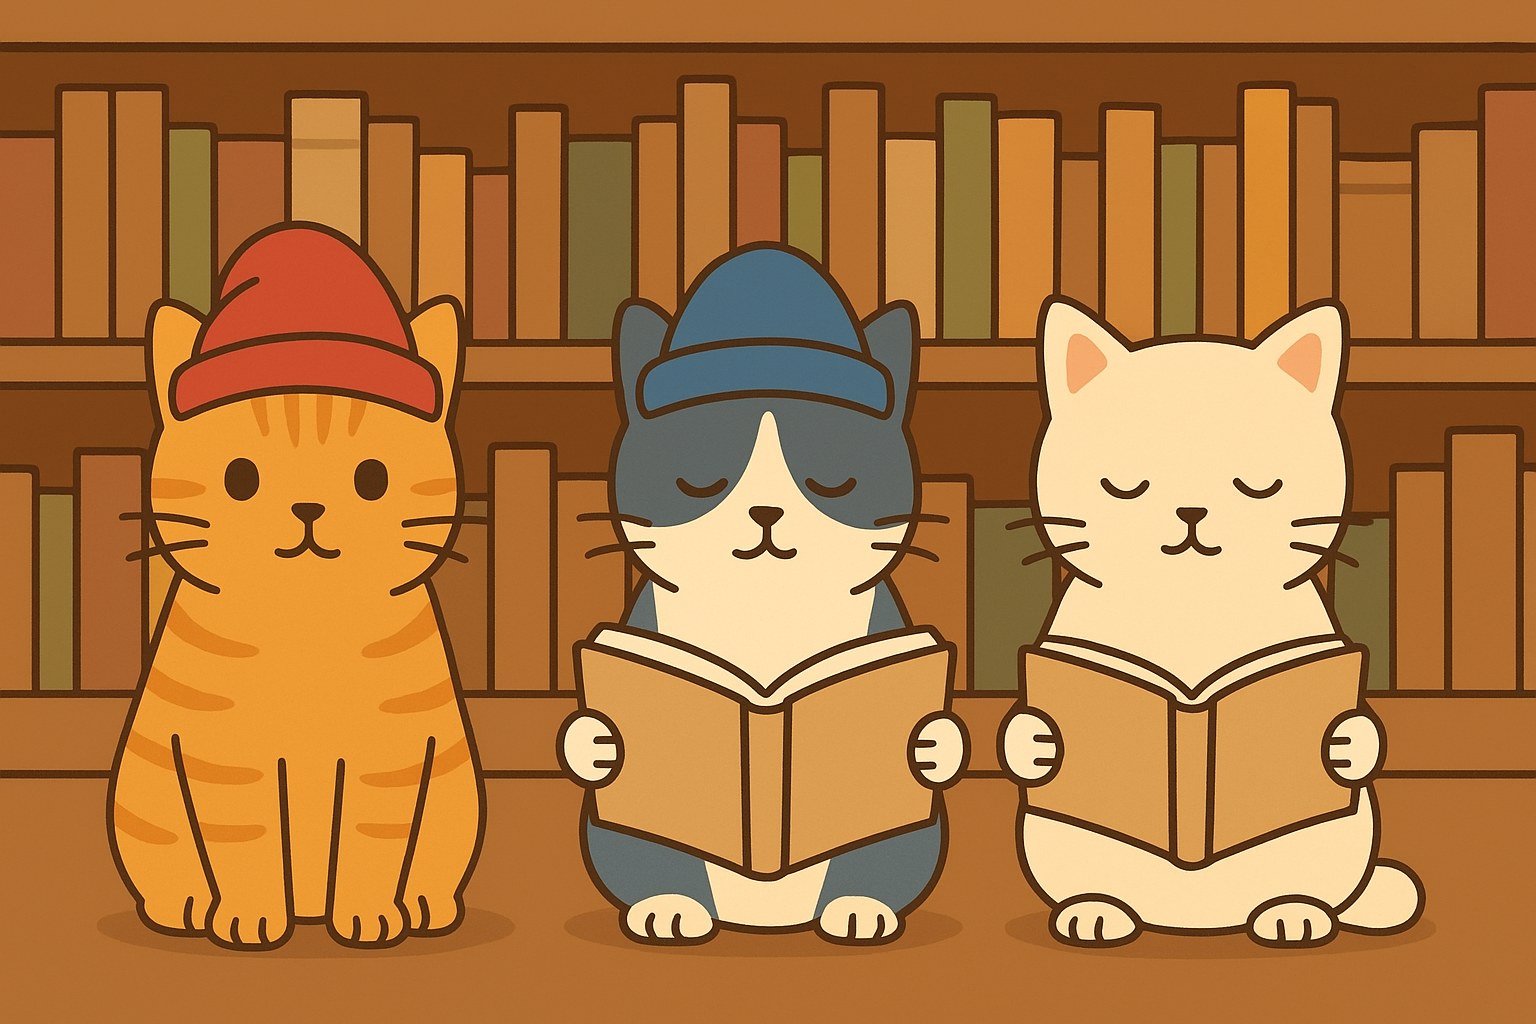
差がついたのは別の場所だ。プロンプトの中で指示を整理するために使った「①②③」という番号を、Nano Banana 2はそのまま画像の中に文字として描いてしまった。
「文字は一切入れない」と明記していたのに、だ。
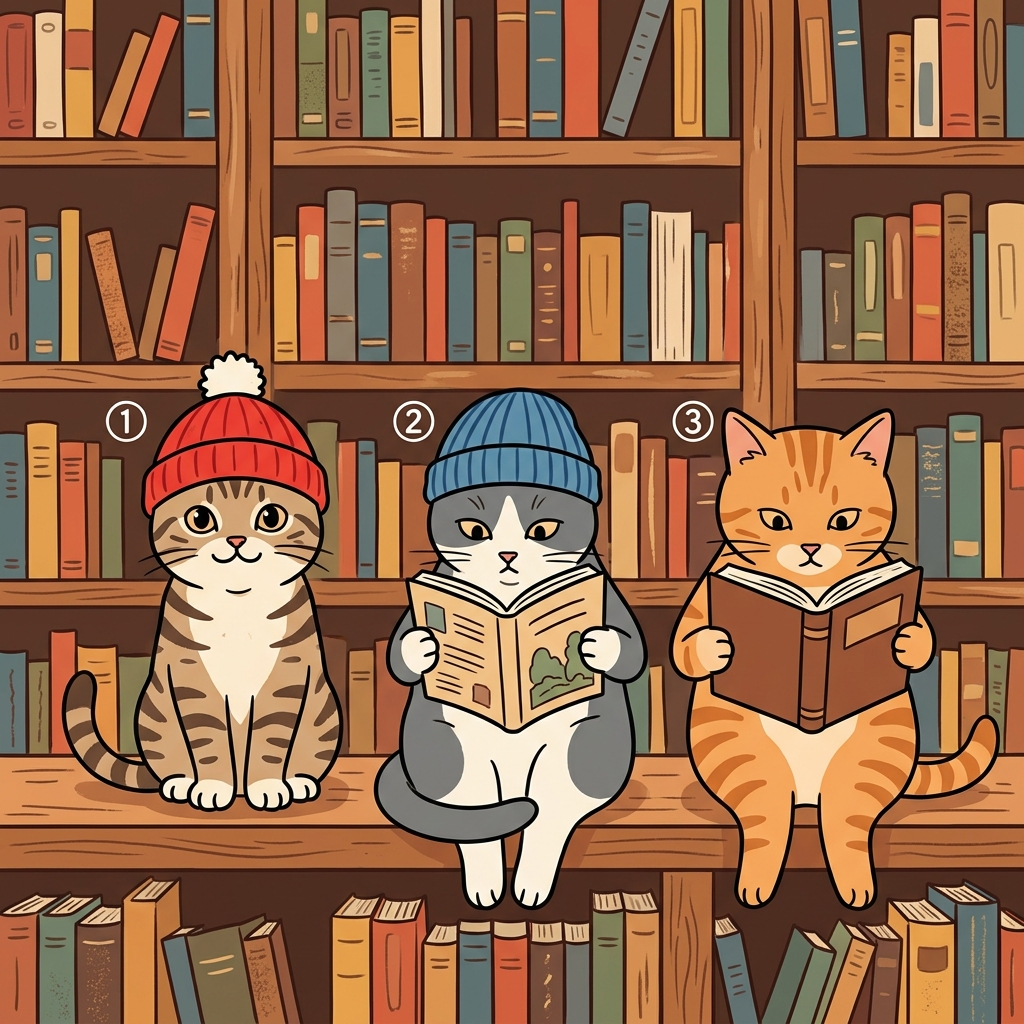
gpt-image-1-miniの方は同じ番号を、純粋に指示の構造として扱い、画像には何も文字を入れなかった。
「指示を整理するための記号」と「画像に描くべき内容」を区別できるかどうか。複雑なプロンプトを渡すときに効いてくるのは、こういう地味な部分だった。
じゃあ、何を基準に選べばいいのか
3つのテストをまとめると、こうなる。
- 計算・論理の正確さ:今の主要モデル同士では、もう大きな差はない
- 判断への踏み込み方:「断言して」と指示すれば、どのモデルも逃げない。ただし理由の専門性・解像度は変わる。実務の細部を聞くなら、その分野の一次情報を多く学習していそうなモデルを選ぶ
- 複雑な指示への忠実さ:条件を詰め込むほど、指示と内容の境界線を正しく引けるかどうかで差が出る。特に画像生成は、プロンプトの構造そのものを描いてしまう事故がある
うちが普段やっている使い分けも、この結果と矛盾しない。
画像生成は解像度とコストで選ぶ。
2K超が必須ならgpt-image-2一択。1枚$0.50〜1.00で、
この解像度に対応するのは今のところこれだけだ。
2K以下なら、写実的な風景や大気感が主役の絵はNano Banana 2、
動物やキャラクターの再現性が要る絵はgpt-image-1が強い。
ただし今回のテストで分かった通り、
複雑な構図を頼むときはNano Banana 2の出力を必ず目視でチェックする。
指示の記号が絵に混入していないか、ここだけは機械的に見落とせる。
文章・戦略は、方針が固まっていない段階はClaude、
決まった後の実装や数値根拠はCodexに振る。重要な案件は両方を並走させる。
リサーチ・事実確認は、1系統のAIの回答をそのまま信じない。
これは今週、自分が実際にやられた話だ。ある記事ページについて要約ツールに「中身を確認して」と頼んだら、「ほぼ空のページだ」ともっともらしく返ってきた。
生データを直接見たら、実際には8,200文字ちゃんと入っていた
AIの言い方の自信度は、合っている時も間違っている時も変わらない
だから重要な事実確認は、別系統のAIにもう一度同じ問いを投げて、
答えが一致するかを見る。一致しなければ、そこで初めて人が生データに戻る
まとめ:用途別の使い分け
- 計算・論理:GPT-5.5とGemini Proで差なし。どちらでも良い、罠を疑う癖の方が大事
- 判断・断言:3体とも逃げないが理由の解像度に差。実務の細部が要るならGemini、一般論ならどちらでも
- 複雑な画像プロンプト:Nano Banana 2が指示記号を誤描画。複雑な構図は出力を必ず目視チェック
- 高解像度画像(2K超):対応は事実上gpt-image-2一択
- リサーチ・事実確認:AIの自信度は正誤で変わらない。重要な確認は必ず2系統でクロスチェック
「AIはどれも同じ」を確かめずに決めつけている限り、一番弱いところで損をする。実際に同じ問題を投げてみるのが、結局一番早い。


